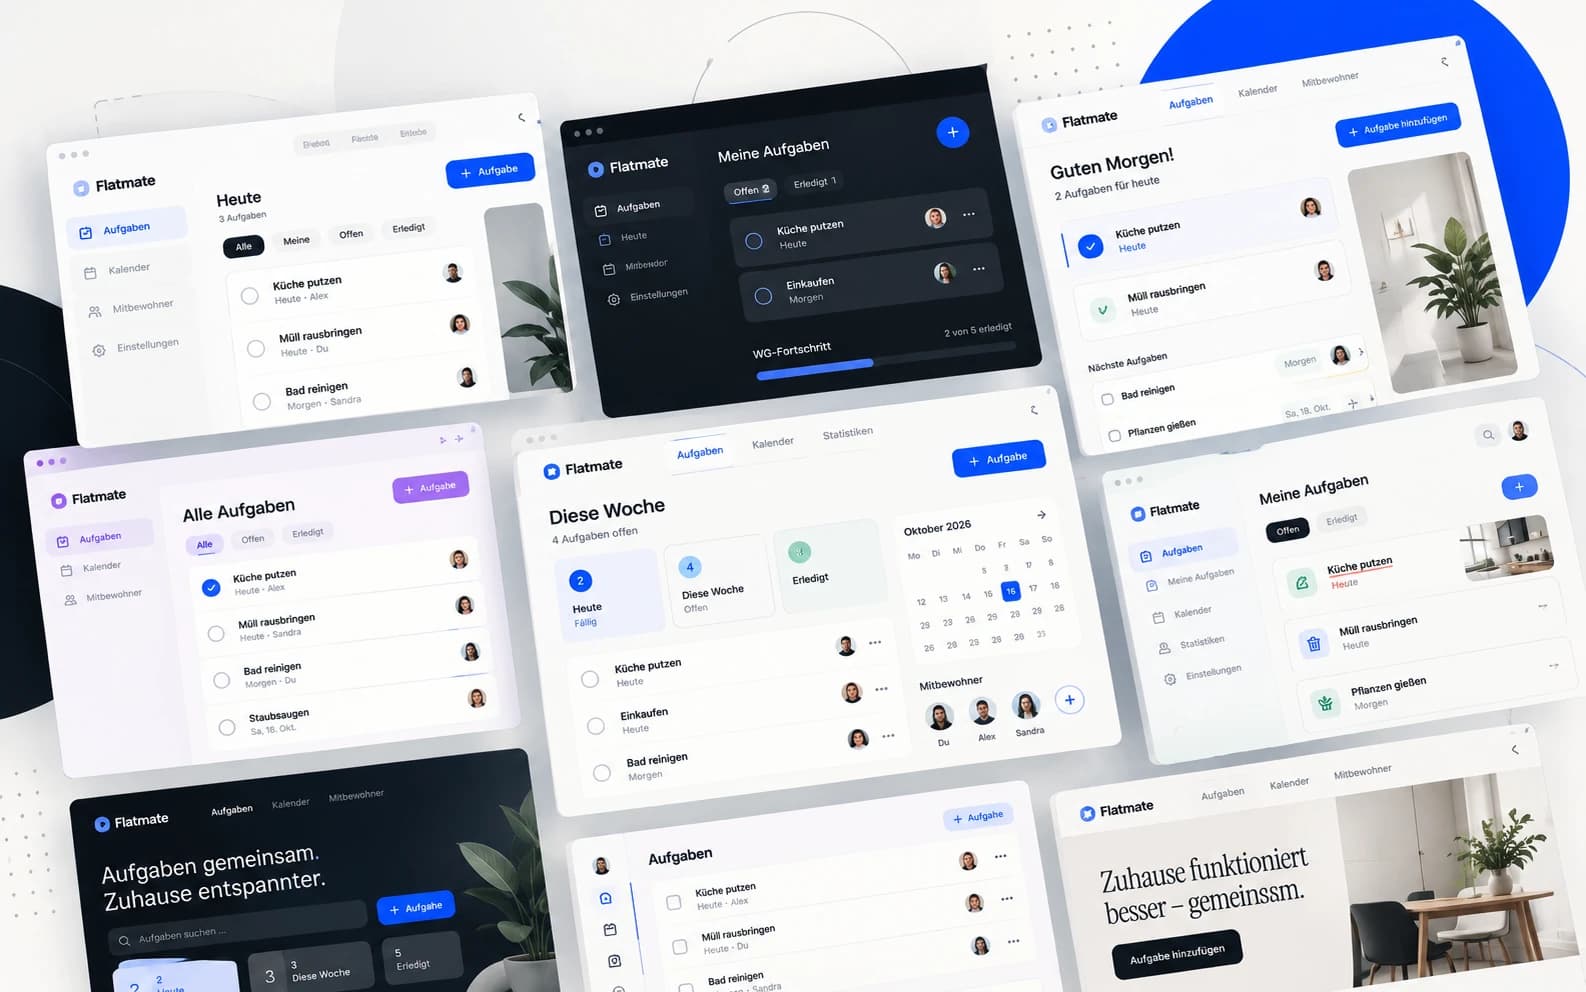
In einer Wohngemeinschaft gibt es eine Frage, die erstaunlich zuverlässig für Diskussionen sorgt: Wer hätte eigentlich die Küche putzen sollen?
Vielleicht hängt ein handgeschriebener Putzplan am Kühlschrank. Vielleicht organisiert ihr euch über eine WhatsApp-Gruppe, in der wichtige Nachrichten zwischen Einkaufslisten und Memes verschwinden. Oder ihr habt längst eine gemeinsame Aufgaben-App, die inzwischen niemand mehr so richtig verwendet.
Eigentlich wäre eine kleine Anwendung praktisch, die genau dieses Problem löst. Jeder sieht seine Aufgaben, kann neue hinzufügen und erledigte Einträge abhaken. Mehr braucht es für den Anfang nicht.
Mit einem KI-Coding-Assistenten lässt sich aus dieser Idee relativ schnell ein Prototyp entwickeln. Man beschreibt die gewünschten Funktionen, lässt den Code generieren und arbeitet so lange weiter, bis die Anwendung läuft.
Was mich daran besonders interessiert, ist allerdings nicht der Code.
Es sind die vielen kleinen Entscheidungen, die eine KI trifft, obwohl wir sie nie ausdrücklich darum gebeten haben.
Stehen offene Aufgaben ganz oben oder zeigt die Startseite zunächst eine Zusammenfassung? Ist die wichtigste Aktion ein großer Button oder ein kleines Pluszeichen? Wie erkennt jemand, dass eine Aufgabe bereits erledigt wurde? Und was passiert, wenn das Speichern fehlschlägt?
All diese Dinge gehören zum Design. Manche sind sichtbar, andere fallen erst auf, wenn man versucht, die Anwendung tatsächlich zu benutzen.
Für unser nächstes Experiment wollen wir deshalb bewusst einen Teil der Verantwortung abgeben. Wir beschreiben einer KI, was unsere WG-App können soll, überlassen ihr zunächst die Gestaltung und prüfen anschließend, welche Entscheidungen dabei entstanden sind.
Danach wiederholen wir die Aufgabe mit einem deutlich präziseren UX-Briefing.
Die Frage ist nicht, ob KI hübsche Websites erstellen kann. Das ist längst nicht mehr der interessanteste Maßstab.
Wir wollen wissen, was passiert, wenn ein System nicht nur den Code, sondern auch einen großen Teil der Produktentscheidungen übernimmt.
Der erste Prompt enthält weniger Design, als man denkt
Viele KI-Projekte beginnen mit einer Beschreibung, die ungefähr so aussieht:
Erstelle eine moderne und responsive Web-App für eine Wohngemeinschaft. Die Bewohner sollen gemeinsame Aufgaben sehen, neue Aufgaben anlegen, diese einer Person zuweisen und als erledigt markieren können. Die Oberfläche soll professionell und benutzerfreundlich aussehen.
Eigentlich klingt das nach einem vernünftigen Auftrag. Die wichtigsten Funktionen sind enthalten, die Anwendung soll auf unterschiedlichen Bildschirmgrößen funktionieren und die Gestaltung soll einen professionellen Eindruck machen.
Nur bleibt erstaunlich viel offen.
Was bedeutet in diesem Zusammenhang „professionell“? Soll die Anwendung wie ein klassisches Verwaltungsdashboard aussehen, mit Seitenleiste und verschiedenen Übersichten? Oder wäre eine einfache Liste sinnvoller, die man morgens auf dem Smartphone öffnet?
Und was genau heißt „benutzerfreundlich“?
Diese Beschreibung verrät nichts darüber, welche Aufgaben die Bewohner besonders häufig erledigen. Sie sagt auch nicht, ob eher neue Aufgaben angelegt oder bestehende abgehakt werden. Selbst die Frage, ob die Anwendung hauptsächlich auf dem Smartphone genutzt wird, bleibt der Interpretation des Systems überlassen.
Natürlich kann die KI trotzdem eine plausible Lösung erzeugen.
Sie kennt verbreitete Interface-Muster und kann sich an ihnen orientieren. Das ist häufig hilfreich, denn etablierte Komponenten und vertraute Abläufe erleichtern die Bedienung.
Aber eine naheliegende Lösung ist nicht automatisch die beste Lösung für eine konkrete Situation.
Bei einer WG-App könnte ein übersichtliches Dashboard sinnvoll sein. Vielleicht genügt aber auch eine Liste mit zwei Ansichten: „Meine Aufgaben“ und „Alle Aufgaben“.
Welcher Aufbau besser funktioniert, hängt davon ab, was die Bewohner tatsächlich benötigen.
Und genau das möchten wir herausfinden.
Warum ausgerechnet eine WG-App?
Für ein Experiment über KI-Design könnte man eine aufwendige SaaS-Plattform entwickeln, eine Buchungswebsite nachbauen oder ein umfangreiches Dashboard generieren lassen.
Ich würde bewusst kleiner anfangen.
Unsere fiktive Anwendung heißt Flatmate und soll drei Personen bei der Organisation ihrer gemeinsamen Haushaltsaufgaben unterstützen.
Die Idee ist überschaubar. Es gibt Aufgaben, Zuständigkeiten, Fälligkeitstermine und einen Status, der anzeigt, ob etwas erledigt wurde.
Trotzdem steckt darin mehr UX, als man zunächst vermutet.
Nehmen wir an, Alex öffnet die App am Freitagmorgen. Eigentlich möchte Alex nur wissen, welche Aufgaben heute noch anstehen.
Eine Anwendung könnte jetzt sämtliche Aufgaben der WG anzeigen, unabhängig davon, wer dafür zuständig ist. Das wäre funktional korrekt, aber möglicherweise wenig hilfreich.
Eine andere Variante stellt die eigenen offenen Aufgaben in den Vordergrund. Wieder eine andere zeigt zuerst die zuletzt bearbeiteten Einträge.
Keine dieser Entscheidungen ist automatisch richtig oder falsch. Sie verfolgen unterschiedliche Prioritäten.
Ähnlich sieht es beim Anlegen einer Aufgabe aus.
Braucht es dafür eine eigene Seite oder genügt ein kleines Formular? Muss die zuständige Person bereits beim Erstellen ausgewählt werden? Wie wird verhindert, dass jemand versehentlich eine Aufgabe doppelt anlegt?
Und wenn Alex die Küche geputzt hat und auf „Erledigt“ klickt, sollte die Anwendung das Ergebnis eindeutig bestätigen. Andernfalls bleibt vielleicht die Unsicherheit, ob der Eintrag tatsächlich gespeichert wurde.
Das sind keine exotischen Designprobleme.
Es sind gewöhnliche Situationen, die in fast jeder produktiven Anwendung vorkommen. Gerade deshalb eignet sich Flatmate als Testobjekt.
Zwei Briefings, dieselbe Anwendung
Der eigentliche Versuch basiert auf einer einfachen Gegenüberstellung.
In der ersten Variante erhält die KI hauptsächlich die funktionalen Anforderungen. Sie weiß, was die App können soll, aber kaum etwas über die gewünschte Nutzerführung.
In der zweiten Variante beschreiben wir zusätzlich die wichtigsten Nutzeraufgaben und einige konkrete Gestaltungsprinzipien.
Das funktionale Ziel bleibt gleich.
Variante A: Die KI entscheidet weitgehend selbst
Erstelle eine moderne, responsive Web-App für eine Wohngemeinschaft.
Die Bewohner sollen gemeinsame Aufgaben sehen, neue Aufgaben anlegen, diese einer Person zuweisen und als erledigt markieren können.
Gestalte eine professionelle, benutzerfreundliche Oberfläche. Verwende lokale Beispieldaten.
Mehr geben wir zunächst nicht vor.
Die KI entscheidet damit weitgehend selbst über Navigation, Layout, visuelle Hierarchie, Komponenten und Interaktionsmuster.
Das ist kein unfairer Prompt. Er entspricht einer durchaus üblichen Arbeitsweise, bei der jemand eine Produktidee beschreibt und sich zunächst einen brauchbaren Prototypen erstellen lässt.
Variante B: Die KI erhält ein UX-Briefing
Entwickle eine mobile Web-App für drei WG-Bewohner, die ihre gemeinsamen Haushaltsaufgaben organisieren.
Die wichtigsten Nutzeraufgaben sind: offene Aufgaben schnell erkennen, eine Aufgabe einer Person zuweisen und eine bestehende Aufgabe als erledigt markieren.
Priorisiere offene Aufgaben auf der Startseite. Verwende verständliche Beschriftungen, eine eindeutige Hauptaktion und eine klare Informationshierarchie.
Berücksichtige leere Listen, Erfolgs- und Fehlerzustände, Tastaturbedienung, lesbare Kontraste und die Darstellung auf einem 375 Pixel breiten Smartphone.
Entwickle ein konsistentes, zurückhaltendes Designsystem. Überprüfe die wichtigsten Abläufe und begründe wesentliche Designentscheidungen.
Hier verändert sich der Auftrag deutlich.
Wir geben nicht vor, welche Schriftart verwendet werden muss oder wie rund die Buttons sein sollen. Stattdessen beschreiben wir die Situationen, in denen Menschen die Anwendung verwenden, und legen Anforderungen fest, die sich anschließend überprüfen lassen.
Die KI erhält damit weniger Freiheit bei der Interpretation des Problems, aber weiterhin ausreichend Spielraum für die konkrete Gestaltung.
Das ist der Unterschied, auf den es uns ankommt.
Wir wollen nicht einfach zwei unterschiedliche Designs erzeugen. Wir wollen untersuchen, was geschieht, wenn das System mit einer klareren Vorstellung von Nutzern und Aufgaben arbeitet.
Ein hübscher Screenshot beweist erstaunlich wenig
Bei der Bewertung von KI-generierten Interfaces gibt es eine Versuchung, der wir bewusst widerstehen möchten: den ersten Screenshot anzuschauen und sofort ein Urteil zu fällen.
Wenn die Farben harmonieren, die Typografie gut gewählt ist und die Komponenten sauber ausgerichtet sind, wirkt die Anwendung schnell professionell.
Das kann durchaus eine gestalterische Leistung sein.
Nur sagt es wenig darüber aus, was passiert, wenn jemand die Anwendung benutzt.
Eine Aufgabenliste kann wunderschön aussehen und trotzdem unverständlich sortiert sein. Ein Formular kann visuell perfekt gestaltet sein, aber notwendige Fehlermeldungen vermissen lassen. Und ein Button kann sich bei einem Klick elegant animieren, ohne dass die zugrunde liegende Aktion erfolgreich abgeschlossen wurde.
Diese Unterschiede sind gerade beim Vibe Coding interessant, weil die visuelle Ausarbeitung häufig sehr früh entsteht.
Die Anwendung sieht unter Umständen bereits fertig aus, bevor ihre wichtigsten Nutzungsabläufe überprüft wurden.
Deshalb möchten wir Flatmate nicht allein anhand der Startseite beurteilen.
Stattdessen soll jede generierte Version dieselben Aufgaben erfüllen.
Aufgabe 1: Was muss ich heute erledigen?
Eine Testperson öffnet Flatmate und versucht herauszufinden, welche Aufgabe sie als Nächstes erledigen soll.
Wir prüfen, ob die eigene Zuständigkeit und der Aufgabenstatus verständlich dargestellt sind. Außerdem interessiert uns, wie leicht sich relevante von weniger relevanten Informationen unterscheiden lassen.
Wenn dafür erst mehrere Menüs geöffnet werden müssen, ist das eine andere Nutzererfahrung als bei einer unmittelbar sichtbaren Aufgabenliste.
Aufgabe 2: Wer putzt die Küche?
Die Testperson soll eine neue Aufgabe mit dem Titel „Küche putzen“ anlegen, Alex zuweisen und als Fälligkeit Freitag auswählen.
Hier geht es um die Auffindbarkeit der Funktion, die Verständlichkeit des Formulars und die Frage, wie die Anwendung mit unvollständigen oder fehlerhaften Angaben umgeht.
Wir möchten beispielsweise wissen, ob die zuständige Person eindeutig ausgewählt werden kann und ob nach dem Speichern erkennbar ist, was passiert ist.
Aufgabe 3: Die Arbeit ist erledigt
Zum Schluss markiert die Testperson eine Aufgabe als abgeschlossen.
Die Anwendung sollte den Status sichtbar verändern und verständlich bestätigen, dass die Änderung übernommen wurde.
Idealerweise lässt sich eine versehentlich abgeschlossene Aufgabe wieder öffnen.
Gerade diese scheinbar einfache Handlung eignet sich gut, um den Unterschied zwischen einer hübschen Oberfläche und einem durchdachten Interaktionsablauf zu erkennen.
Ein Häkchen ist schnell gestaltet.
Ein verlässlicher Zustand dahinter benötigt etwas mehr Aufmerksamkeit.
Das Problem beginnt oft dort, wo der Screenshot endet
Viele UX-Probleme werden erst sichtbar, wenn etwas nicht nach Plan läuft.
Was zeigt Flatmate an, wenn noch keine Aufgaben angelegt wurden? Bleibt eine große weiße Fläche zurück? Erscheint eine unverständliche Meldung wie „No data available“? Oder erklärt die Anwendung, dass bislang keine Aufgaben vorhanden sind, und bietet direkt die Möglichkeit, eine neue anzulegen?
Solche sogenannten Empty States werden leicht übersehen.
Dabei gehören sie zu den Zuständen, die gerade bei neuen Anwendungen häufig auftreten.
Ähnlich interessant ist die Frage, was passiert, wenn ein Speichervorgang länger dauert.
Zeigt die Oberfläche eine Rückmeldung? Lässt sich die Aktion versehentlich mehrfach auslösen? Und wenn die Änderung fehlschlägt, weiß die Person anschließend, ob sie es erneut versuchen sollte?
In den Usability-Heuristiken von Jakob Nielsen spielt die Sichtbarkeit des Systemstatus eine zentrale Rolle. Ein System soll den Menschen verständlich darüber informieren, was gerade geschieht und welches Ergebnis ihre Aktionen haben.
Für unser Experiment ist das besonders relevant.
Eine Aufgaben-App, die das Speichern nicht verständlich bestätigt, kann Unsicherheit erzeugen, obwohl der zugrunde liegende Code technisch funktioniert.
Allerdings müssen wir bei der Bewertung vorsichtig sein.
Unsere Testversionen verwenden lokale Beispieldaten. Eine erfolgreiche Änderung innerhalb dieses Prototyps ist deshalb nicht mit dem zuverlässigen Speichern in einer produktiven Mehrbenutzer-Anwendung gleichzusetzen.
Für Flatmate ist das in Ordnung. Wir testen zunächst das Interface und grundlegende Abläufe, nicht die vollständige Infrastruktur eines marktreifen Produkts.
Der Unterschied muss später im Ergebnisbericht erkennbar bleiben.
Barrierefreiheit gehört ebenfalls auf den Prüfstand
Neben der visuellen Gestaltung möchten wir überprüfen, wie zugänglich die generierten Oberflächen sind.
Dafür betrachten wir zunächst Kontraste, Beschriftungen und Tastaturbedienbarkeit.
Ein einfaches Beispiel: Kann jemand eine Aufgabe als erledigt markieren, ohne die Maus zu verwenden?
Wenn die Funktion als echtes Button-Element umgesetzt wurde, ist die Tastaturinteraktion in vielen Fällen bereits besser vorbereitet als bei einem beliebigen klickbaren Container.
Das bedeutet allerdings nicht, dass damit alle Anforderungen erfüllt sind. Auch ein technisch korrektes Bedienelement benötigt eine verständliche Beschriftung und einen sichtbaren Fokuszustand.
Die Web Content Accessibility Guidelines, kurz WCAG, geben dafür überprüfbare Kriterien vor.
Für gewöhnlichen Text ist auf Konformitätsstufe AA grundsätzlich ein Kontrastverhältnis von mindestens 4,5:1 vorgesehen. Für großen Text beträgt der Mindestwert 3:1. Darüber hinaus stellen die WCAG Anforderungen an Tastaturbedienung, Eingabefelder und die technische Erkennbarkeit von Statusmeldungen.
Wir möchten deshalb sowohl automatisierte Prüfungen durchführen als auch die wichtigsten Abläufe manuell überprüfen.
Dabei ist eine Einschränkung wichtig: Ein automatisierter Accessibility-Scan kann nicht zuverlässig feststellen, ob eine Anwendung vollständig barrierefrei ist.
Das W3C weist ausdrücklich darauf hin, dass dafür fachkundige menschliche Beurteilung notwendig bleibt.
Auch in unserem Experiment wäre ein fehlerfreier Scan somit kein Beweis für vollständige Zugänglichkeit.
Er wäre lediglich ein Teil der Bewertung.
Kann ein genauerer Prompt wirklich einen Unterschied machen?
Die Frage klingt zunächst einfach. Je genauer wir ein Problem beschreiben, desto wahrscheinlicher sollte das Ergebnis unseren Vorstellungen entsprechen.
Bei generativen KI-Werkzeugen ist der Zusammenhang allerdings nicht ganz so geradlinig.
Ein ausführlicher Prompt kann wichtige Anforderungen präzisieren. Er kann aber auch widersprüchliche Vorgaben enthalten, die Kreativität unnötig einschränken oder das Modell dazu bringen, bestimmte Kriterien nur oberflächlich abzuarbeiten.
Deshalb sollten wir nicht schon vor dem Versuch davon ausgehen, dass Variante B automatisch besser sein wird.
Interessanter ist, welche Eigenschaften sich tatsächlich verändern.
Vielleicht legt die KI mit dem UX-Briefing mehr Wert auf verständliche Beschriftungen und sichtbare Zustände. Vielleicht erzeugt sie eine klarere Informationshierarchie, aber gleichzeitig eine visuell weniger interessante Oberfläche.
Es könnte ebenso passieren, dass beide Varianten sehr ähnlich ausfallen.
Oder dass sich die Ergebnisse zwischen einzelnen Generierungen stärker unterscheiden als zwischen den beiden Prompt-Arten.
Dass solche Schwankungen vorkommen können, zeigt eine im April 2026 veröffentlichte systematische Literaturübersicht von Gizem Irmak und Qusay H. Mahmoud. Die Forschenden analysierten 20 Studien zu generativen No-Code-Werkzeugen und stellten fest, dass identische Anweisungen je nach System und Durchlauf unterschiedliche Interface-Ergebnisse hervorbringen können.
Besonders interessant ist ihre Beobachtung, dass diese Werkzeuge nicht einfach neutrale Übersetzer menschlicher Anforderungen sind. Sie bringen eigene gelernte Gestaltungsmuster und Interpretationen in den Entstehungsprozess ein.
Genau deshalb wollen wir nicht nur eine einzige Generierung betrachten.
Geplant sind zwei KI-Werkzeuge, zwei Briefings und jeweils zwei unabhängige Durchläufe. Insgesamt sollen acht Prototypen entstehen.
Diese Anzahl reicht nicht aus, um allgemeingültige Aussagen über die Leistungsfähigkeit aller KI-Coding-Assistenten zu treffen. Sie erlaubt uns aber, innerhalb eines überschaubaren Experiments Unterschiede sichtbar zu machen und einzelne Ergebnisse nicht vorschnell zu verallgemeinern.
Wichtig wird dabei, dass wir dieselben funktionalen Anforderungen verwenden und die Erstentwürfe zunächst nicht manuell nachbessern.
Wenn eine Generierung nicht funktioniert, ist auch das ein Ergebnis, das dokumentiert werden muss.
Vielleicht ist die erste Lösung gar nicht das größte Problem
Bei unserem Experiment interessiert mich noch eine zweite Frage.
Was passiert, wenn wir uns zu früh auf einen Entwurf festlegen?
Angenommen, eine KI liefert auf Anhieb ein optisch stimmiges Dashboard. Links eine kleine Navigation, oben drei Kennzahlen und darunter die Aufgabenliste.
Das wirkt zunächst plausibel.
Vielleicht wären die Kennzahlen sogar nützlich. Möglicherweise interessiert es die Bewohner, wie viele Aufgaben in dieser Woche erledigt wurden.
Aber brauchen sie diese Information wirklich jedes Mal, wenn sie die Anwendung öffnen?
Die Gefahr liegt darin, dass ein fertig gestalteter Entwurf unsere weiteren Entscheidungen beeinflusst. Wir beginnen dann, ihn zu verbessern, statt zu hinterfragen, ob die Grundstruktur überhaupt sinnvoll ist.
Vielleicht verbringen wir Zeit damit, eine Statistik-Karte visuell aufzuwerten, obwohl sie auf der Startseite keinen relevanten Zweck erfüllt.
Eine Microsoft-Research-Arbeit vom März 2026 beschäftigt sich mit diesem Problem aus einer breiteren Perspektive. Unter dem Titel Interrogating Design Homogenization in Web Vibe Coding untersuchen Donghoon Shin und seine Mitautoren, wie KI-gestützte Webentwicklung zu einer Vereinheitlichung gestalterischer Lösungen beitragen könnte.
Die Arbeit schlägt unter anderem ein Konzept vor, das zunächst etwas widersprüchlich klingt: Productive Friction.
Gemeint sind bewusste Momente der Reflexion im ansonsten möglichst reibungslosen Generierungsprozess.
Wer eine Website in wenigen Minuten erstellen lassen kann, erhält schnell etwas Sichtbares. Das spart Zeit, kann aber auch dazu führen, dass wichtige Entscheidungen gar nicht mehr bewusst getroffen werden.
Eine kleine Unterbrechung könnte deshalb hilfreich sein.
Bevor wir die erste Flatmate-Version übernehmen, könnten wir beispielsweise fragen, welche Nutzeraufgabe ihre Startseite eigentlich priorisiert. Oder ob es einen grundsätzlich anderen Aufbau gibt, der denselben Zweck besser erfüllt.
Solche Fragen verursachen zunächst zusätzlichen Aufwand.
Sie können aber verhindern, dass wir viel Zeit in die Ausarbeitung einer Lösung investieren, die nie ernsthaft hinterfragt wurde.
Was wir nach der Generierung verändern würden
Nach dem eigentlichen Vergleich möchten wir einen der entstandenen Entwürfe auswählen und bewusst überarbeiten.
Dabei geht es nicht darum, der KI einen menschlichen Designer gegenüberzustellen und anschließend zu behaupten, eine Seite habe gewonnen.
Das wäre schon deshalb problematisch, weil ein solcher Vergleich von vielen zusätzlichen Faktoren beeinflusst würde: Erfahrung, verfügbare Zeit, persönliche Vorlieben und unterschiedliche Kenntnisse über das Produkt.
Stattdessen möchten wir zeigen, wie sich konkrete UX-Beobachtungen in Designentscheidungen übersetzen lassen.
Nehmen wir an, die Aufgabenliste einer Version stellt sämtliche Einträge gleichberechtigt dar. Offene Aufgaben, bereits erledigte Aufgaben und Einträge anderer Bewohner besitzen dieselbe visuelle Gewichtung.
Eine mögliche Verbesserung wäre, offene und eigene Aufgaben stärker hervorzuheben. Abgeschlossene Einträge könnten in einen weniger dominanten Bereich verschoben werden.
Ob diese Änderung sinnvoll ist, hängt natürlich vom tatsächlichen Nutzungskontext ab. In einer WG, die vor allem gemeinsame Fortschritte dokumentieren möchte, könnte eine andere Struktur geeigneter sein.
Genau deshalb sollte ein Redesign nicht aus beliebigen Verschönerungen bestehen.
Es braucht eine begründete Annahme darüber, welches Problem gelöst werden soll.
Eine zweite Änderung könnte die Rückmeldung beim Abschließen einer Aufgabe betreffen. Wenn die Anwendung lediglich das Häkchen einfärbt, könnten wir eine eindeutigere Bestätigung und eine Möglichkeit zum Rückgängigmachen ergänzen.
Bei einem Formular würden wir überprüfen, welche Felder notwendig sind und wie Fehler erklärt werden.
Vielleicht zeigt sich am Ende, dass nur wenige Änderungen erforderlich sind. Vielleicht muss aber auch die gesamte Informationsarchitektur überarbeitet werden.
Beides wäre eine interessante Erkenntnis.
Der Wert eines solchen Redesigns liegt nicht allein darin, dass die Oberfläche danach schöner aussieht.
Er liegt darin, dass wir erklären können, warum bestimmte Entscheidungen getroffen wurden.
Woran wir den Erfolg messen wollen
Bevor wir die Prototypen erzeugen, müssen wir uns deshalb auf nachvollziehbare Kriterien einigen.
Zunächst überprüfen wir, ob die drei zentralen Aufgaben überhaupt funktionieren: eine eigene Aufgabe finden, eine neue Aufgabe zuweisen und einen Eintrag als erledigt markieren.
Anschließend betrachten wir Orientierung, Interaktionsfeedback, mobile Darstellung und Barrierefreiheit.
Die visuelle Gestaltung erhält eine eigene Bewertung. Dabei interessieren uns Konsistenz, Hierarchie und die Frage, ob Komponenten sinnvoll aufeinander abgestimmt sind.
Wir sollten diese Kriterien jedoch nicht zu einer einzigen scheinbar objektiven Punktzahl vermischen.
Eine Anwendung mit besonders schöner Typografie kann trotzdem einen fehlerhaften Buchungs- oder Speicherablauf besitzen. Umgekehrt kann eine optisch unspektakuläre Oberfläche ihre Aufgaben hervorragend erfüllen.
Ein Durchschnittswert würde solche Unterschiede möglicherweise verdecken.
Stattdessen möchten wir festhalten, welche Aufgaben funktionieren, welche Probleme auftreten und welche gestalterischen Entscheidungen besonders auffallen.
Wenn wir später geeignete Testpersonen einbeziehen, könnten wir zusätzlich beobachten, wo Menschen zögern oder scheitern.
Solche qualitativen Tests können wertvolle Hinweise liefern. Auch sie würden bei einer kleinen Teilnehmerzahl allerdings keine repräsentativen Aussagen über sämtliche Nutzer erlauben.
Unser Anspruch sollte deshalb nicht sein, mit acht KI-Generierungen die allgemeine Designqualität künstlicher Intelligenz zu beweisen.
Wir möchten nachvollziehbar zeigen, welche Entscheidungen in einem konkreten Fall getroffen wurden und was Entwickler daraus lernen können.
Was dieses Experiment über Vibe Coding verraten könnte
Es wäre einfach, den Artikel mit einer vorgefertigten Botschaft enden zu lassen.
Etwa damit, dass KI zwar schnell programmiert, aber niemals gutes Design ersetzen kann. Oder umgekehrt, dass die richtigen Prompts schon ausreichen, um professionelle UX nahezu automatisch zu erzeugen.
Beide Schlussfolgerungen wären voreilig.
Wir wissen noch nicht, wie die Flatmate-Prototypen aussehen werden. Vielleicht überraschen uns die Werkzeuge mit durchdachten Lösungen. Vielleicht funktionieren die wichtigsten Abläufe bereits beim ersten Versuch hervorragend.
Vielleicht entdecken wir aber auch, dass bestimmte Details regelmäßig übersehen werden.
Besonders interessant wäre es, wenn das ausführlichere UX-Briefing zwar die visuelle Gestaltung kaum verändert, dafür aber zu verständlicheren Formularen, besseren Rückmeldungen oder einer sinnvolleren Aufgabenstruktur führt.
Das wäre ein Hinweis darauf, dass wir beim Prompting häufig zu viel über Ästhetik und zu wenig über Nutzungssituationen sprechen.
Ebenso könnte sich zeigen, dass bestimmte Probleme selbst mit einem präzisen Briefing bestehen bleiben.
Dann müssten wir genauer untersuchen, ob die Einschränkungen am Modell, am gewählten Werkzeug, am Kontext oder an unserem Versuchsaufbau liegen.
Gerade diese Unsicherheit gehört für mich zu einem guten Experiment.
Denn wenn wir nur nachweisen möchten, dass unsere ursprüngliche Meinung richtig war, brauchen wir eigentlich keinen Versuch durchzuführen.
Die interessantere Frage kommt nach dem ersten Prompt
Was ich bereits jetzt für eine sinnvolle Arbeitshypothese halte: Der wichtigste Teil KI-gestützter Softwareentwicklung wird nicht immer darin bestehen, den perfekten ersten Prompt zu schreiben.
Mindestens ebenso wichtig dürfte werden, wie wir die entstandenen Ergebnisse beurteilen und verbessern.
Eine KI kann ein Layout vorschlagen. Sie kann Komponenten erzeugen, Zustände implementieren und verschiedene visuelle Varianten entwickeln.
Aber spätestens wenn wir entscheiden müssen, ob die Oberfläche zu den Bedürfnissen unserer Nutzer passt, benötigen wir nachvollziehbare Kriterien.
Diese Kriterien können aus Forschung, Gestaltungsprinzipien und vor allem aus dem tatsächlichen Nutzungskontext stammen.
Vielleicht wird Flatmate am Ende aus einer übersichtlichen Liste, einem kleinen Formular und wenigen gut gestalteten Zuständen bestehen. Vielleicht entwickelt eines der Werkzeuge eine überzeugendere Lösung, auf die wir selbst nicht sofort gekommen wären.
Das Experiment ist bewusst offen angelegt.
Bis die Ergebnisse vorliegen, bleibt deshalb auch die Antwort offen, ob ein konkreteres UX-Briefing die Qualität unserer Anwendung tatsächlich verbessert.
Eines sollten wir aber schon vor dem Test nicht verwechseln: Eine KI, die in wenigen Minuten eine Website erzeugt, hat damit zunächst bewiesen, dass sie eine Website erzeugen kann.
Ob daraus ein gutes Produkt entsteht, entscheidet sich erst, wenn jemand versucht, es zu benutzen.
Und genau dort beginnt unser eigentlicher Test.
Die Versuchsanordnung im Überblick
| Bestandteil | Geplante Umsetzung |
|---|---|
| Testanwendung | Flatmate – mobiler WG-Aufgabenplaner |
| KI-Werkzeuge | Zwei Coding-Assistenten, Versionen werden dokumentiert |
| Bedingungen | Allgemeines Briefing und UX-orientiertes Briefing |
| Wiederholungen | Jeweils zwei unabhängige Generierungen |
| Gesamtumfang | Acht Prototypen |
| Nutzeraufgaben | Aufgaben finden, anlegen und abschließen |
| Prüfung | Funktionalität, UX-Heuristiken, Mobile, Accessibility und Gestaltung |
| Nachbereitung | Begründetes Redesign eines ausgewählten Entwurfs |
| Veröffentlichung der Ergebnisse | Nach Durchführung und Dokumentation der Tests |
Quellen und weiterführende Literatur
Donghoon Shin et al. (März 2026): Interrogating Design Homogenization in Web Vibe Coding. Microsoft Research. Untersuchung möglicher Vereinheitlichungseffekte und des Ansatzes der Productive Friction.
Gizem Irmak & Qusay H. Mahmoud (April 2026): Design Behaviour and Interface Consistency in Generative No-Code Tools: A Systematic Literature Review. Computers, 15(4). Literaturübersicht zu Designentscheidungen, Variabilität und Konsistenz generierter Interfaces.
Jakob Nielsen: 10 Usability Heuristics for User Interface Design. Nielsen Norman Group. Grundlegende Prinzipien zur Bewertung von Benutzeroberflächen.
W3C: Web Content Accessibility Guidelines (WCAG) 2.2. Anforderungen an die Zugänglichkeit digitaler Oberflächen.
W3C Web Accessibility Initiative: Evaluating Web Accessibility. Methoden und Grenzen automatisierter und manueller Accessibility-Prüfungen.
Redaktioneller Hinweis: Dieser Beitrag beschreibt die Fragestellung und Methodik eines geplanten UI-Unbound-Experiments. Die acht KI-Generierungen, die funktionalen Prüfungen und etwaige Nutzertests wurden noch nicht durchgeführt. Die geschilderten WG-Situationen sind illustrative Beispiele, keine dokumentierten Testergebnisse. Ein gesonderter Ergebnisbericht folgt erst nach der tatsächlichen Durchführung.
Weiterlesen: Warum KI-generierte Websites oft gleich aussehen · UI/UX für Vibe Coder: Der praktische Einstieg.